Google Veo 3.1
Veo 3.1 把写下来的场面变成电影感的视频,对白和音效已经对好了。给它一张开始图和一张结束图,它会把中间的运动补上;片子结束得太早,也可以接着往下延。
Veo 3.1 的核心能力
素材转视频
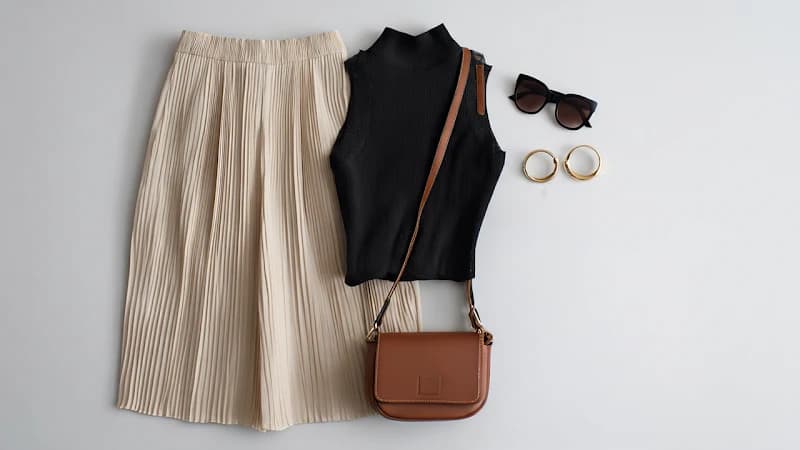
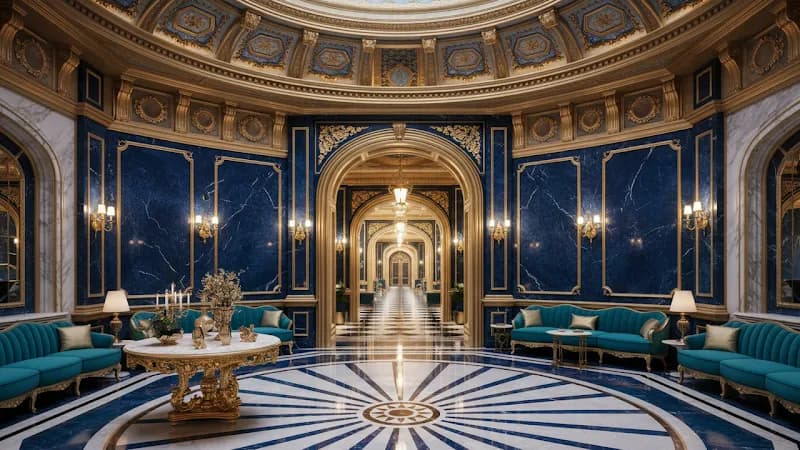
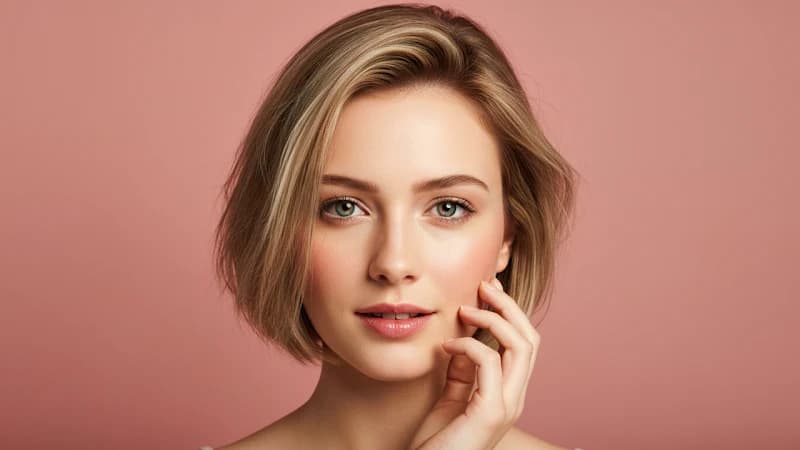
参考图能定住文字最不擅长的那些东西:一张具体的脸、某个产品的具体质感、一个房间里光线的确切分量。Veo 3.1 最多收三张,在提示词推动情节的同时,把图里的内容整条片子稳住。用文字描述一套调色,得写一句你会改四遍的话;递一张静帧过去,只要上传一次。
输入图片 1
输入图片 2
输入图片 3
Prompt:
Close up shot of woman with sunglasses on top of her head, gold hood earrings, is walking in the interior, she is lost and asks where everyone is and what's going on.
场景延长
一次生成跑八秒。当你要的那个点落在第九秒时,过去的办法是整条重新生成,然后祈祷第二次能对上。Veo 3.1 拿最后一帧当起点继续往下走——镜头还按原来的方式在动,光没变,声音也不会从静音重新开始。串几段下来,你就远远越过了八秒的天花板,而且接缝处不用剪掉任何东西。
输入视频
Prompt 1: Graceful dancer is slowly dancing to classical music.
Prompt 2: A male dancer comes in, gracefully dancing with the woman as classical music plays.
Prompt 3: More dancers show up on the stage.
Prompt 4: The classical music continues, and the dancers continue to dance.
输出视频
帧转视频
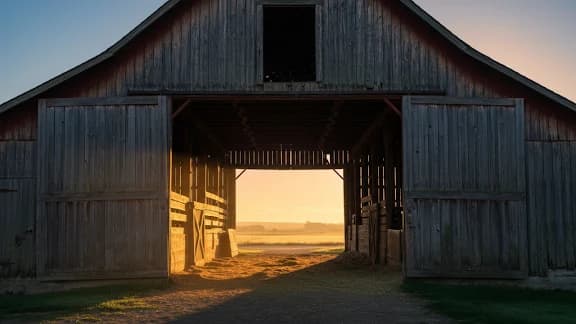
开场长什么样、收尾长什么样,你已经知道了。Veo 3.1 负责中间那段——运镜、节奏、底下垫的声音。如果你想要某个特定的运镜,而不是模型自己挑的那个,在提示词里点名就行。因为两端都锁在你自己选的图上,结果拖进时间线时不用再修剪。
首帧
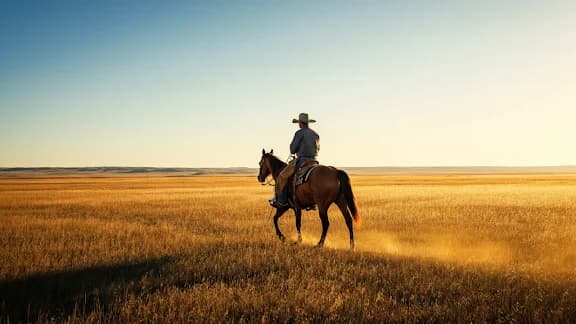
尾帧
Prompt:
Camera soars through the barn to the cowboy riding away.
输出视频
同一个角色,一条接一条
下周换个场景,用一条跟上次毫无共同点的提示词,把同一个人再叫回来。把上次用过的参考图交给 Veo 3.1——或者从已经做好的片子里抽一帧——脸、发型和服装就会一起回来。其余部分随便变:新地点、新光线、新机位、新动作。能在八次、十次生成之间守住同一个身份,你手上就有了一组“演员”,短片段也是从这时候开始能攒成一个东西的。
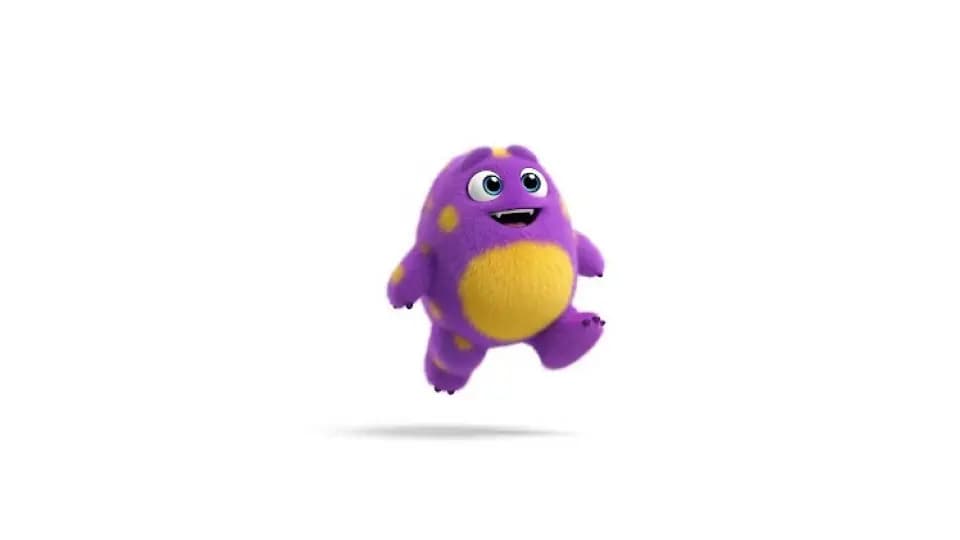
输入图片
Prompt: a monster walking toward the camera
输出视频
Prompt: a cute monster dancing
输出视频
Prompt: a cute monster swimming underwater
输出视频
Prompt: a cute monster walking in a candy wonderland
竖着拍,用 4K 交付
Veo 3.1 是原生生成 9:16,而不是把横屏裁下来,所以竖版能完整保住构图,两侧不会削掉重要的东西。分辨率最高到 4K——发个 story 没什么差别,但只要片子要上大屏,或者还要再过一遍调色,差别就很大。与其事后补救,不如在生成前就把画幅和尺寸定下来。
跟画面一起出来的声音
对白、环境声和音效是跟画面一起生成的,不是事后铺上去的——所以门关上的时候,听起来就是那一刻关上的。Veo 3.1 把这一点也铺到了参考图、首尾帧和延长这几条路径上,所以用静帧搭出来的片子拿回来是带声音的,不是哑的。极短片段里的说话仍然是粗糙的地方——谷歌自己也这么说——但环境声和音效通常可以直接拿去用。
对比 Veo 3.1 系列视频模型
| 项目 | Veo 3.1 | Veo 3.1 Fast | Veo 3.1 Lite |
|---|---|---|---|
| 适合场景 | 画质最高、可直接交付的成片 | 更快的生成,更低的成本 | 成本最低的草稿和大批量出片 |
| 输入方式 | 文字、图片和参考图 | 文字、图片和参考图 | 文字和图片 |
| 参考图 | 支持 | 支持 | 不支持 |
| 原生声音 | 内置——对白、音效和环境声 | 内置——对白、音效和环境声 | 内置——对白、音效和环境声 |
| 输出 | 最高 4K,4–8 秒片段 | 最高 4K,4–8 秒片段 | 最高 4K,4–8 秒片段 |
| 画面质量 | 最高 | 高 | 良好 |
| 速度 | 标准 | 更快 | 最快 |
| 相对成本 | 标准 | 更低 | 最低 |
| 什么时候选它 | 需要最精细、能直接给客户看的结果 | 日常片子想要速度和省钱 | 在快速试错,或者在批量出片 |
开始使用
怎么用 Veo 3.1 生成视频
写清楚主体、动作和运镜。想锁住一张脸、一件产品或者一套质感,就加参考图。
一次生成给你八秒带声音的片子。不够就从最后一帧往下延,然后下载 MP4。
准备好生成第一条片子了吗?
YouTube 上关于 AI 视频模型 Google Veo 3.1 的视频
Veo 3.1 fully tested
AI Search
Google Veo 3.1 is INSANE - Full Tutorial
Roboverse
The New Google VEO 3.1 Tested and Explained: Create Ultra-Realistic AI Videos Fast!
AI Edge Mastery
Google Flow | Veo 3.1 Tutorial & Real Test Results
AI2Play
Master Google Veo 3.1: Mind-Blowing AI Video Results (Full Guide)
Invideo for Filmmaking
How To Use Google VEO 3.1 | Create Realistic AI Videos Step-by-step (Full Tutorial)
BIG JOHNAB
Ultimate VEO 3.1 Update EXPLAINED: How To Use Google Veo-3 For Beginners
AI Master
How I Use VEO 3.1 To Create Viral Videos In 9 Minutes
Nicky Saunders
X 上关于 AI 视频模型 Google Veo 3.1 的帖子
Will Smith in Veo 3.1 pic.twitter.com/SuK9jky3NW
— AI Search (@aisearchio) October 15, 2025
Veo is getting a major upgrade. 🚀
— Google DeepMind (@GoogleDeepMind) October 15, 2025
We’re rolling out Veo 3.1, our updated video generation model, alongside improved creative controls for filmmakers, storytellers, and developers - many of them with audio. 🧵 pic.twitter.com/YQVRxwj7hk
Ok, Google.
— Koldo Huici (@koldo2k) October 15, 2025
Let’s put VEO 3.1 to the test.
Better prompt adherence and smoother visuals in text-to-video ⚡
Prompts 👇 pic.twitter.com/mBvgnxDDB9
The Good News:
— Alex Patrascu (@maxescu) October 15, 2025
Veo 3.1 is available in Google Flow!
The Bad News:
It's a minor, but significant upgrade pic.twitter.com/BYUxu0dAmU
Veo 3.1 + Nano Banana is insane 🤯
— PJ Ace (@PJaccetturo) October 15, 2025
Google’s new models let us make million-dollar looking ads for brands like Wander.
Copy our entire process for making this ad below 👇🧵pic.twitter.com/HL2TIzPVnY
Veo 3.1
— Tatiana Tsiguleva (@ciguleva) October 15, 2025
I2V tests.
Overall, it's really good!
I love the sounds a lot. pic.twitter.com/fyZ5bbnfSH
Meet Veo 3.1 👋
— Google AI (@GoogleAI) October 17, 2025
With Veo 3.1, you can generate videos with richer audio, better narrative control, and enhanced realism. This new update also comes with a suite of additional features built for creative control.
Including the ability to:
— Extend your videos to make them longer… pic.twitter.com/WMH9TQH0w5
Veo 3 is the state-of-the-art in video models. Veo 3.1 is our new big upgrade with enhanced realism, richer audio, scene extension, better narrative control, more precise editing capabilities & much more. Enjoy creating with it at https://t.co/QgTpxTKAOi and in the @GeminiApp ! https://t.co/kCoE8meIb6
— Demis Hassabis (@demishassabis) October 15, 2025
THE PUMPKIN MURDERERS 🎃
— Travis Davids (@MrDavids1) October 22, 2025
Veo 3.1 extend feature is actually really good! It was extended from a single frame to 43 seconds long. Besides midjourney, Google has managed to make extensions completely seamlessly without jarring visual indications when an extensions occurs. However,… pic.twitter.com/CuU5Y23yAA
Veo3.1 → Edit Feature.
— Rory Flynn (@Ror_Fly) October 15, 2025
Tested it with a more complex visual.
Some misses...but still impressive.
PROCESS:
1. Generate Initial Video
2. Select the "pencil" icon.
3. Add edits + generate.
INITIAL PROMPT:
A silver-haired woman dances with precision and intensity inside a dimly… pic.twitter.com/yfZr4VhNAc
Today, Veo 3.1 Ingredients to Video is getting more expressive + portrait mode has arrived (we heard you!)
— Sundar Pichai (@sundarpichai) January 13, 2026
You can now create vertical clips with livelier movement and better control directly in the @Geminiapp, @YouTube & Google Vids.
All this plus state-of-the-art upscaling to… pic.twitter.com/vCvGEelldS
Google DeepMind Veo 3.1 is something else, social media is cooked forever.
— AshutoshShrivastava (@ai_for_success) October 9, 2025
This video is claimed to be created using Veo 3.1, and I’m adding a screenshot in the comments as proof.
Veo 3.1 generates 8-second videos by default, supports both 9:16 and 16:9 formats, and delivers… https://t.co/mknPB43VXf pic.twitter.com/GPfIBmZQhe
Google has updated its Veo 3.1 AI video model with a stronger Ingredients to Video workflow.
— Rohan Paul (@rohanpaul_ai) January 13, 2026
Ingredients just means the input “parts” you give the model up front, usually a subject image, a background image, and a style or look reference.
Veo uses those images as anchors while… https://t.co/PIJeGNj3Tp pic.twitter.com/yN5uZGlbiE
Tested @FlowbyGoogle's Veo 3.1 + new controls: game-changer!
— SD | AI Animation Storyteller (@SDXLHQ) November 6, 2025
From "prompt-and-pray" to interactive director suite. Insane accuracy & detail. Ends random generations; build scenes layer-by-layer like an editor.
All UI features in demo video attached👇#veo31 #GoogleAI #AIart pic.twitter.com/Zhd8j2pA5n
🥵Google's VEO 3.1 video generation model is set for imminent release on Gemini and Vertex AI! 🎬 Get ready for:
— Times Of Cinema (@Times_of_Cinema) October 15, 2025
🔹 Longer clips (potential 30 seconds!)
🔹 Refined audio-visual quality
This launch is poised to significantly advance generative media for creators and enterprise… pic.twitter.com/hFfPRa3cFv
The Official Release has finally dropped! Veo-3.1 is here!
— Theoretically Media (@TheoMediaAI) October 15, 2025
After a week of biting my tongue at the "leaked specs" we can finally start putting this update through it's paces!
3.1's video model enhancements are one thing, but the real sauce here is in the new features!
(more) pic.twitter.com/Yo8Ke3fKA4
Updates to Veo 3.1 📹 in the Gemini API and AI Studio:
— Logan Kilpatrick (@OfficialLoganK) January 13, 2026
- We now support upsampling to 1080p and 4K
- Improved ingredients (image reference) to video consistency
- Vertical video support for ingredients to video
So much Veo progress in the last few months, lots to build : )
We’re setting a new standard for AI video creation at work.
— Google Workspace (@GoogleWorkspace) October 15, 2025
The new Veo 3.1 model in Google Vids gives you higher quality videos with richer audio, more narrative control, & enhanced realism — helping you produce videos that tell your story beautifully. https://t.co/de2POcj4sQ
Exclusive: First real samples of Veo 3.1 generated videos - TestingCatalog https://t.co/xk1sxzsG4h
— audai (@audaiuk) October 11, 2025
Google's Veo-3.1 revolutionizes AI video with precise frame controls and ingredient blending. Tip: Use "ingredients" in prompts like "Combine [char img] with [loc] for dynamic scenes." https://t.co/0atztXSU5n #AIVideo #NewAIModels #GlobalAI
— PromptNinja (@ninja_prompt) October 16, 2025
常见问题
在 MaxH3 上试用 Veo 3.1
免费积分,无需绑卡。参考图、首尾帧控制,以及跟画面一起出来的声音——全在同一个地方。
免费生成的片子带水印。升级后可以干净导出。